Was ist das beste LLM für Übersetzungen? Ein Vergleich der besten KI-Übersetzungsmodelle

Rachel Wolff,March 12, 2025·11 Min. Lesezeit
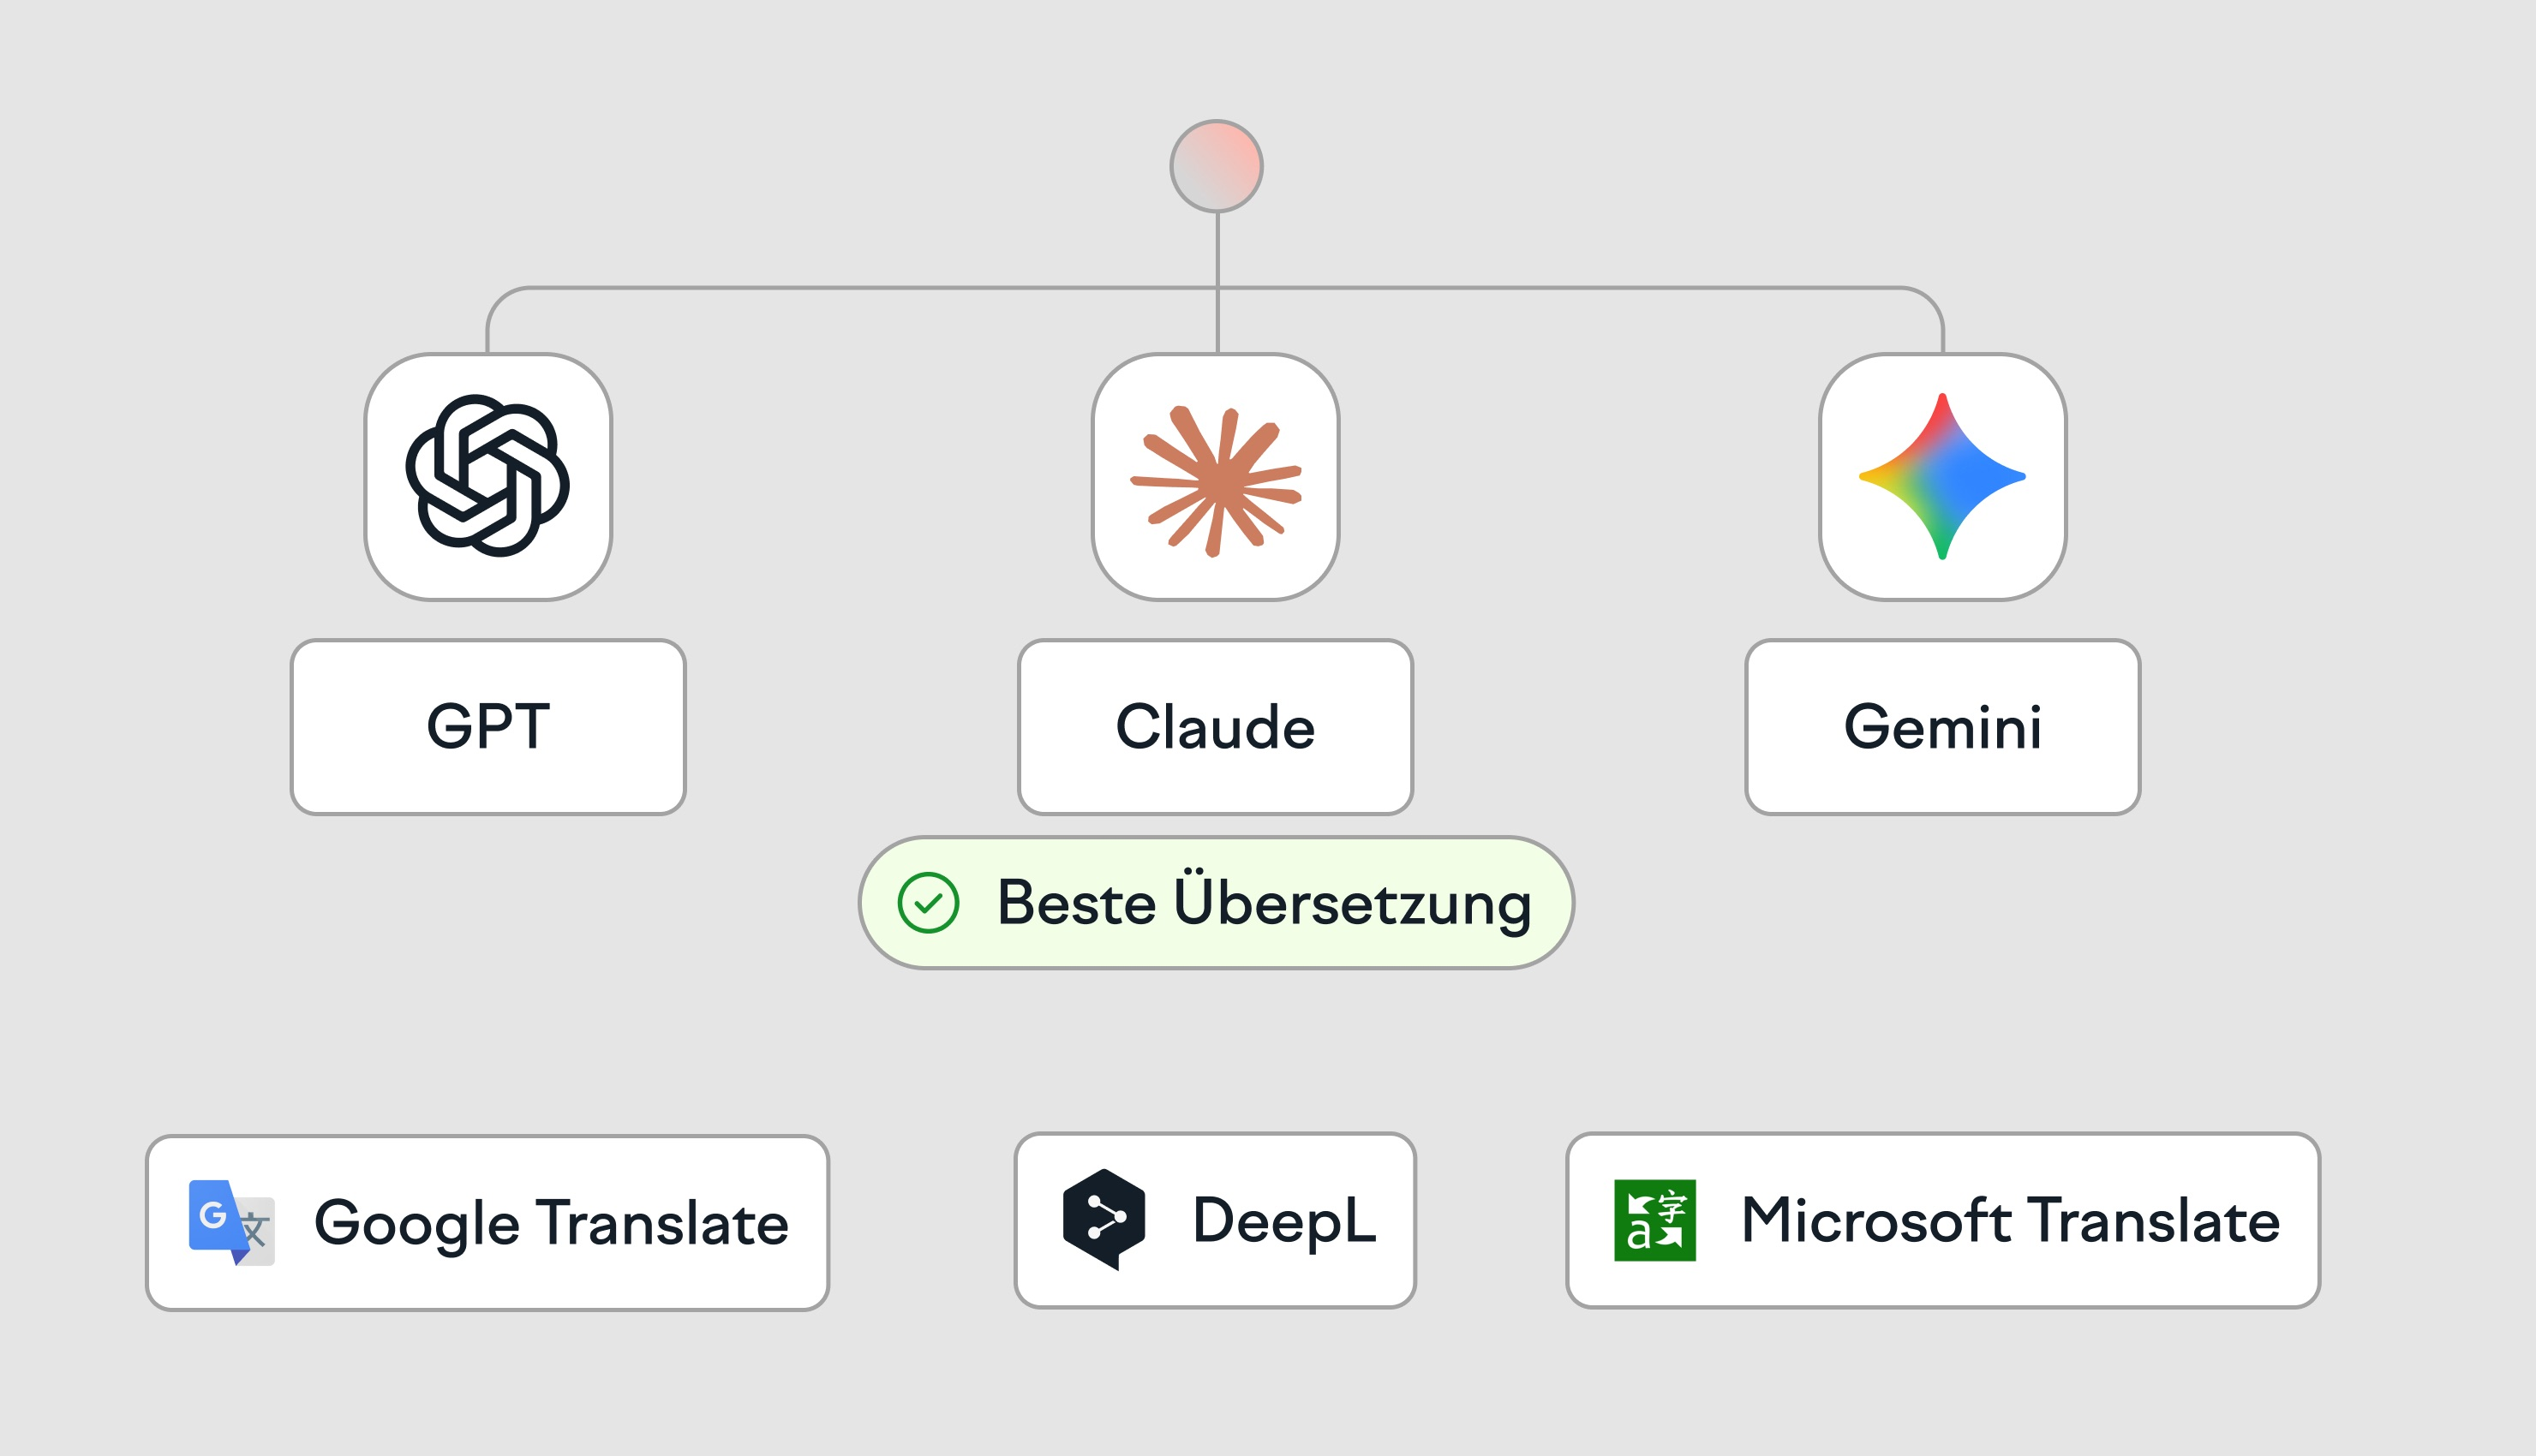
Schema mit allen LLMs auf dem Markt

Welches LLM am besten für Übersetzung geeignet ist, hängt von der jeweiligen Aufgabe ab. Claude ist in der Regel am stärksten bei sehr nuancenreichen, markensensiblen Marketingübersetzungen. GPT-4o/5 schneidet tendenziell am besten bei technischer Dokumentation und Code-Lokalisierung ab. Gemini ist eine gute Wahl, wenn langer Kontext und dateiübergreifende Konsistenz wichtig sind. DeepSeek ist häufig die kostengünstigste Option für umfangreiche Massenübersetzungen mit geringem Risiko.

Aber im Jahr 2026 lautet die Frage nicht mehr, welches Modell insgesamt gewinnt, sondern welches Modell für die konkrete Übersetzungsaufgabe in deiner automatisierten Pipeline am besten geeignet ist. Ziel ist es, für jede Aufgabe das richtige Modell zu wählen und die Qualität im großen Maßstab zu überprüfen.

Lokalise hat mit einem eigens entwickelten Kontrollexperiment getestet, welche LLM-Übersetzung für welche Aufgaben am besten geeignet ist. Im Artikel erfährst du, was wir herausgefunden haben.
 

🔖 Lesezeichen für diesen Artikel setzen

Unser Produktteam veröffentlicht kontinuierlich Erkenntnisse aus eigenen Recherchen zu Large Language Models (LLM) für Übersetzungen, daher wird dieser Artikel regelmäßig aktualisiert.

LETZTES UPDATE (März 2026): Neue Ergebnisse aus der umfassenden Blindvergleichsstudie von Lokalise und der neuesten WMT25-Studie, die die Überlegenheit von LLMs gegenüber herkömmlicher maschineller Übersetzung belegt.

Sind LLMs besser als herkömmliche Tools für maschinelle Übersetzungen?

LLMs sind für viele Übersetzungsaufgaben im Produktivbetrieb die bessere Wahl, während traditionelle MÜ zunehmend als Basis- oder Fallback-Lösung betrachtet wird.
Zum eingehenden Test dieser Aussage führte das Produktteam von Lokalise eine Blindvergleichsstudie mit drei Sprachpaaren (vom Englischen ins Deutsche, Polnische und Russische) auf fünf Systemen durch.    

Dabei wurden zwei LLMs (Claude Sonnet 3.5 und GPT-4o) und drei herkömmliche Tools für maschinelle Übersetzungen (DeepL, Google Übersetzer und Microsoft Translator) getestet.

Da Übersetzungsqualität naturgemäß subjektiv ist, haben wir mit Paarvergleichen durch Muttersprachler und statistische Rankings das Präferenzrauschen reduziert und sind dabei zu Ergebnissen gekommen, auf die wir uns verlassen können.

Ein großes Hindernis bei der KI-Lokalisierung ist Vertrauen. Teams zögern mit einer Automatisierung von Überprüfungen, weil sie davon ausgehen, dass Qualitätsbewertung zu subjektiv ist. Unsere Ergebnisse deuten jedoch darauf hin, dass die Lücke kleiner ist als angenommen.

Zentrale Erkenntnisse:

  • LLMs zeigten eine überlegene Leistung bei allen getesteten Sprachpaaren, wobei die Übersetzungsqualität in 55,7 % bis 80 % der Fälle selbst dann als „gut“ bewertet wurde, wenn jegliche Kontextinformationen fehlten.
  • Claude 3.5 bleibt der Maßstab für einen natürlichen Sprachfluss, während Gemini 2.0 Pro bei der Übersetzung ganzer Repositorys mit langem Kontext führt.
  • Mit LLMs sinkt der mögliche Prüfaufwand: „Gute“ Ergebnisse waren so häufig, dass sich LLMs als erster Durchlauf eignen und menschliche Prüfung auf Ausnahmen beschränkt bleiben kann.

In der gesamten Auswertung lagen die Übereinstimmung von Mensch zu Mensch und von KI zu Mensch dicht beieinander – unabhängig davon, ob sie mit Interrater-Reliabilität (Cohens Kappa) oder Überlappungskennziffern (Average Jaccard Similarity) gemessen wurden.

In einigen Fällen stimmten die Bewertenden stärker mit dem KI-Rankingmodell überein als mit anderen menschlichen Überprüfern.

Was hat die WMT25-Studie herausgefunden?

WMT25 zeigt, dass die leistungsstärksten Übersetzungssysteme zunehmend auf LLM-Basis oder einer hybriden Herangehensweise beruhen. Die Leistungsunterschiede werden deutlicher, wenn für die Bewertung schwierigere, realistischere Testdatensätze statt „einfacher“ Beispiele verwendet werden.

In der WMT25 General Machine Translation Shared Task konnten Teams Systeme für 30 Sprachpaare einreichen, und der Benchmark umfasst menschliche Bewertungen als zentralen Bestandteil der Evaluierung.

Die praktische Schlussfolgerung lautet, dass Entscheidungen über das „beste Modell“ aufgabenbasiert und kontextsensitiv sein sollten. Traditionelle neuronale maschinelle Übersetzung (NMT) wird zunehmend mit LLM-basierten Ansätzen kombiniert (oder von ihnen abgelöst), typischerweise über Fine-Tuning oder als Teil von Pipelines zur Datenbereinigung und Post-Editing.

📚 Weiterführende Texte

Möchtest du wissen, wie KI-Übersetzung funktioniert? Dann lies den verlinkten Leitfaden, der ohne Fachjargon auskommt und daher leicht verständlich ist.

Wie wir LLMs für Übersetzungen getestet haben

Um wissenschaftliche Strenge zu gewährleisten, haben wir mehrere Evaluierungsmethoden eingesetzt, darunter das Bradley-Terry-Modell. Dies ist eine der anerkanntesten statistischen Methoden für das Ranking von Elementen anhand von Paarvergleichen. Dabei handelt es sich um einen probabilistischen Rahmen, der mithilfe von Stärkeparametern modelliert, mit welcher Wahrscheinlichkeit Übersetzung A gegenüber Übersetzung B bevorzugt wird.

Auf diese Weise konnten wir mithilfe der Maximum-Likelihood-Schätzung eine klare Rangfolge der Übersetzungsqualität aufstellen.

Wir haben uns auf ressourcenstarke Sprachen konzentriert, um zwei Hypothesen zu testen: dass LLMs „traditionelle“ MÜ-Systeme inzwischen übertroffen haben und dass LLM-Übersetzungen für ressourcenstarke Sprachen bereits „gut genug“ sind.

Wir haben von Large Language Models Übersetzungen aus dem Englischen in drei Sprachen anfertigen lassen:

  • vom Englischen ins Deutsche
  • vom Englischen ins Polnische
  • vom Englischen ins Russische

Anschließend sollten menschliche Prüfer die Übersetzungsqualität durch Paarvergleiche von Übersetzungen verschiedener Engines bewerten:

  • Für jede Übersetzung verglichen Muttersprachler die Varianten der verschiedenen Engines und markierten die beste
  • Über 600 Paarvergleiche wurden von mehreren menschlichen Prüfern für jedes Sprachpaar durchgeführt

Interessanterweise ist Russisch zwar technisch gesehen eine Sprache mit einer großen Ressourcenmenge, aber positive Bewertungen lagen deutlich unter denen für Deutsch und Polnisch, was darauf hindeutet, dass die Verfügbarkeit von Ressourcen nicht immer direkt mit der Übersetzungsleistung korreliert.
 

📚 Weiterführende Texte

Neugierig auf mehr? Finde heraus, worin der Unterschied zwischen NLP und LLM besteht.

Warum LLM-zuerst-Übersetzungen in Produktionsworkflows besser funktionieren

LLMs übertreffen traditionelle MÜ häufig, weil sie Bedeutung und Intention flexibler verarbeiten – insbesondere, wenn der Workflow den richtigen Kontext liefert. Aus genau diesem Grund hängt die Übersetzungsleistung von der Aufgabenkonfiguration ab, nicht vom Modell.

LLMs wie Claude Sonnet 3.5 und GPT-4o haben mehrere Vorteile bei Übersetzungsaufgaben, die herkömmliche Tools für maschinelle Übersetzungen nicht bieten:

  1. Kontextverständnis: Im Gegensatz zu traditionellen Übersetzungssystemen erfassen LLMs den allgemeinen Kontext eines Textes und ermöglichen dadurch natürlicher klingende Formulierungen
  2. Kulturelle Nuancen: Diese Modelle können idiomatische Sprache, kulturelle Bezüge und Tonalität besser bewahren
  3. Anpassungsfähigkeit: LLMs zeigen eine höhere Flexibilität beim Umgang mit Fachterminologie oder ungewöhnlichen Sprachmustern
  4. Konsistenz: Unsere Tests zeigten eine bemerkenswerte Konsistenz bei der Qualität, wobei das beste LLM bei mehreren Sprachpaaren in 78 % der Fälle gute Übersetzungen lieferte

Da Large Language Models (LLMs) sich weiterentwickeln und neue Modelle veröffentlicht werden, wird die Lücke zwischen der Qualität von LLM-Übersetzungen und traditionellen Tools für maschinelle Übersetzungen nur noch größer werden.
 

So wählst du das richtige LLM für Übersetzung

Zur Auswahl des richtigen LLMs für deine Übersetzung musst du die Stärken des Modells mit deiner konkreten Aufgabe abgleichen. Claude eignet sich gut für sehr nuancenreiche Marketinginhalte, GPT-4o/5 für technische Dokumentation und Code-Lokalisierung und Gemini für Kontext über große Bereiche und dateiübergreifende Einheitlichkeit. Kosteneffiziente Modelle wie DeepSeek eignen sich für umfangreiche Massenübersetzung in einem automatisierten Workflow.

Das richtige Modell hängt davon ab, was du übersetzt, wie viel Kontext du bereitstellen kannst und wie strikt du Formatierung, Terminologie und markentypischen Stil schützen musst.

2026 ist die Frage, welches LLM am besten für Übersetzungen geeignet ist, eine Routing-Entscheidung innerhalb deiner automatisierten Pipeline.

das beste LLM für Übersetzungen

Die vier folgenden Anwendungsfälle spiegeln die häufigsten Übersetzungsaufgaben in automatisierten Workflows wider.

Warum ist Claude besonders für kreative Übersetzungen geeignet?

Claude 3.5/4 ist hervorragend für sehr nuancenreiche Marketingübersetzungen geeignet, bei denen Tonfall, idiomatische Formulierungen und markentypischer Stil darüber entscheiden, ob sich Inhalte wirklich muttersprachlich anfühlen.

Claude ist in der Regel die beste Wahl, wenn ein natürlicher Sprachfluss und nicht nur wörtliche Genauigkeit gefragt ist. Es liefert starke Ergebnisse bei Marketingseiten und UX-Texten, bei denen Ton, Redewendungen und kulturelle Nuancen darüber entscheiden, ob das Ergebnis muttersprachlich und markenkonform wirkt.

Claude eignet sich hervorragend für die Übersetzung kundenorientierter, markensensibler Inhalte – besonders, wenn du es mit Referenzmaterial (vorgegebene Formulierungen, Terminologie, Beispiele) versorgst, damit das Tool sich keinen eigenen Stil ausdenkt.
 

📚 Weiterführende Texte

Entdecke die besten getesteten KI-Übersetzungstools – inklusive Claude.

Warum eignet sich ChatGPT gut für technische Übersetzungen und Code-Übersetzungen?

GPT-4o/5 ist führend bei technischer Dokumentation und Code-Lokalisierung, weil es Variablen, Platzhalter und strukturierte Formatierung zuverlässig beibehält.

ChatGPT ist oft die sicherste Wahl, wenn die Übersetzungsgenauigkeit davon abhängt, wie gut Vorgaben eingehalten werden. Es geht in der Regel zuverlässiger mit Platzhaltern, Variablen und Formatierungsregeln um – was für UI-Texte und technische Dokumentation sowie für codenahe Texte, bei denen die Syntax erhalten bleiben muss, wichtig ist.

ChatGPT eignet sich gut für die Übersetzung strukturierter Inhalte, bei denen eine etwas weniger elegante Formulierung akzeptabel ist.

Warum sollte Gemini für Übersetzungen mit langem Kontext und über mehrere Dateien hinweg genutzt werden?

Gemini-Modelle mit großem Kontextfenster sind eine gute Wahl, wenn deine Übersetzungsaufgabe nicht aus einem einzelnen Text, sondern aus einer ganzen Sammlung zusammenhängender Dateien besteht, die einheitlich übersetzt werden müssen.

Mit einem Kontextfenster von bis zu 2 Millionen Tokens ist Gemini nützlich für die Übersetzung umfangreicher Dokumentationssätze, Repositorys oder Mehrdatei-Exporte, bei denen Namen, Terminologie und Formulierungen abschnittsübergreifend gleich bleiben müssen.

Warum eignet sich DeepSeek besonders für kosteneffiziente Massenübersetzungen?

Das Preismodell von DeepSeek ist ausdrücklich auf Kosteneffizienz in großem Maßstab ausgerichtet, was es attraktiv für große Batches und kontinuierliche interne Workflows macht.

DeepSeek ist oft die beste Option, wenn es um umfangreiche Übersetzungen mit geringem Risiko geht und Kosten sowie Durchsatz im Vordergrund stehen. Dazu können interne Updates, Entwürfe und Masseninhalte gehören, die verständlich sein müssen, aber keinen hochwertigen Marketingstil benötigen.

Da sich LLMs ständig weiterentwickeln und neue Versionen veröffentlicht werden, ist es schwierig, stets im Blick zu behalten, welches Übersetzungsmodell bei welchem Bedarf gewählt werden sollte. Genau hier kommt Lokalise ins Spiel.

🧠 Gut zu wissen

Lokalise hat keine Präferenz für ein bestimmtes LLM, sondern sorgt dafür, dass Kunden für das jeweilige Sprachpaar stets das leistungsstärkste LLM erhalten. So ist niemand an ein einzelnes Modell gebunden, während sich die KI-Technologie weiterentwickelt.

So automatisiert Lokalise die LLM-Auswahl in Produktions-Workflows

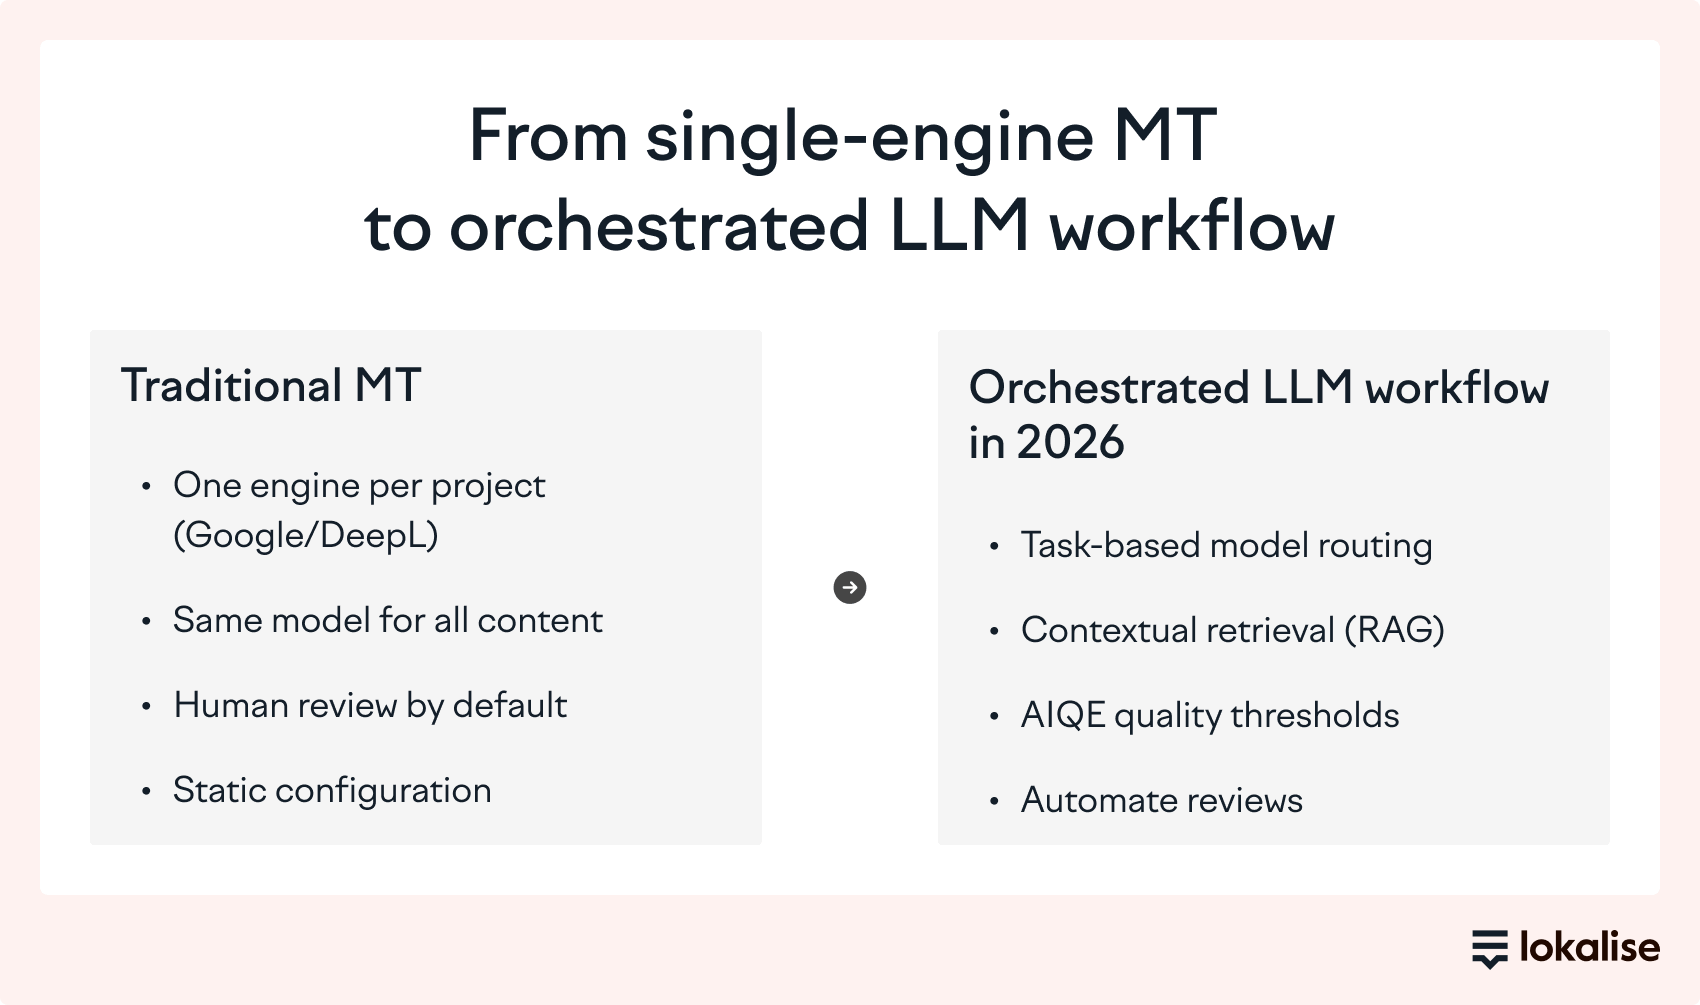
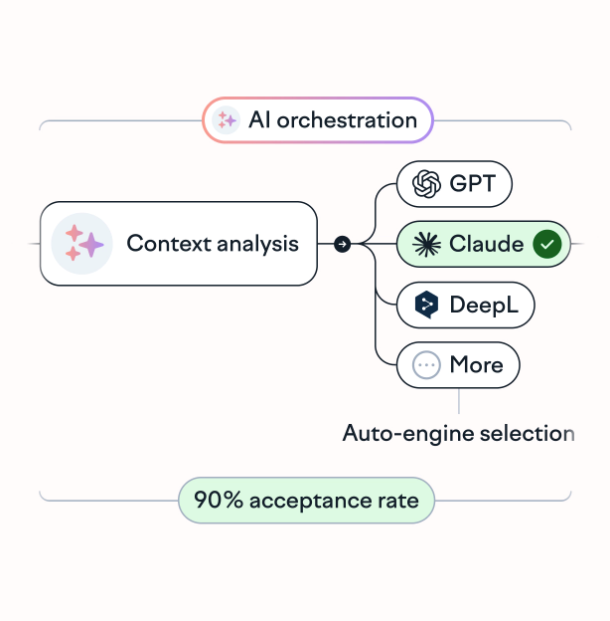
Der Lokalise AI Orchestrator wählt dynamisch das optimale LLM auf Basis von Sprachpaar, Inhaltstyp und Workflow-Beschränkungen aus. Genauer gesagt:

  • Beim dynamischen Modell-Routing wird für jede Übersetzungsaufgabe das passende LLM ausgewählt
  • Benutzerdefinierte KI-Profile sorgen dafür, dass deine Terminologie und dein Markenstil verwendet werden
  • Retrieval (RAG) versorgt das Modell mit passenden, abgesegneten Übersetzungen aus dem Translation Memory
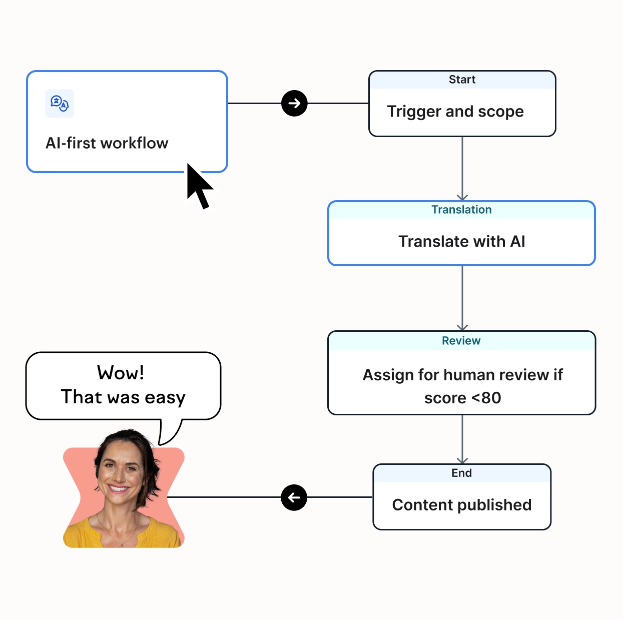
  • Mit AIQE-Bewertungen wird gekennzeichnet, welche Übersetzungen veröffentlichungsreif sind und welche noch einmal von Menschen geprüft werden sollten
KI-Orchestrierung in Lokalise.webp

Schauen wir uns die einzelnen Schritte genauer an.

Dynamisches Modell-Routing (aufgabenbewusste Auswahl)

Bei unterschiedlichen Übersetzungsaufgaben sind unterschiedliche Stärken gefragt. Bei Marketingtexten sind Ton und Stil wichtig. Bei UI-Texten muss besondere Rücksicht auf Platzhalter gelegt werden. In Dokumentation ist eine strukturelle Einheitlichkeit erforderlich.

Der Lokalise AI Orchestrator ordnet jedem Übersetzungsauftrag das Modell zu, das sich am besten für diese Aufgabe eignet, statt für alle Inhalte dieselbe Engine zu erzwingen.

Das bedeutet: Kreative Inhalte können von Claude erledigt werden, strukturierte technische Texte von GPT-Modellen, Assets mit langem Kontext von Gemini und umfangreiche interne Batches von kosteneffizienten Engines. Die Auswahl erfolgt automatisch innerhalb der Pipeline – nicht manuell pro Projekt.

Benutzerdefinierte KI-Profile verankern das Modellverhalten in deinem Fachbereich

Benutzerdefinierte KI-Profile in Lokalise verbessern die Übersetzungsqualität, indem sie jedem Auftrag domänenspezifische Anweisungen, Terminologieregeln und Stilvorgaben zuweisen.

Anstatt dich auf generisches Systemverhalten zu verlassen, kannst du festlegen, wie sich das Modell für Marketing-, Rechts-, Support- oder Technikinhalte verhalten soll. Das reduziert stilistische Abweichungen und verhindert uneinheitliche Terminologie über Versionen hinweg.

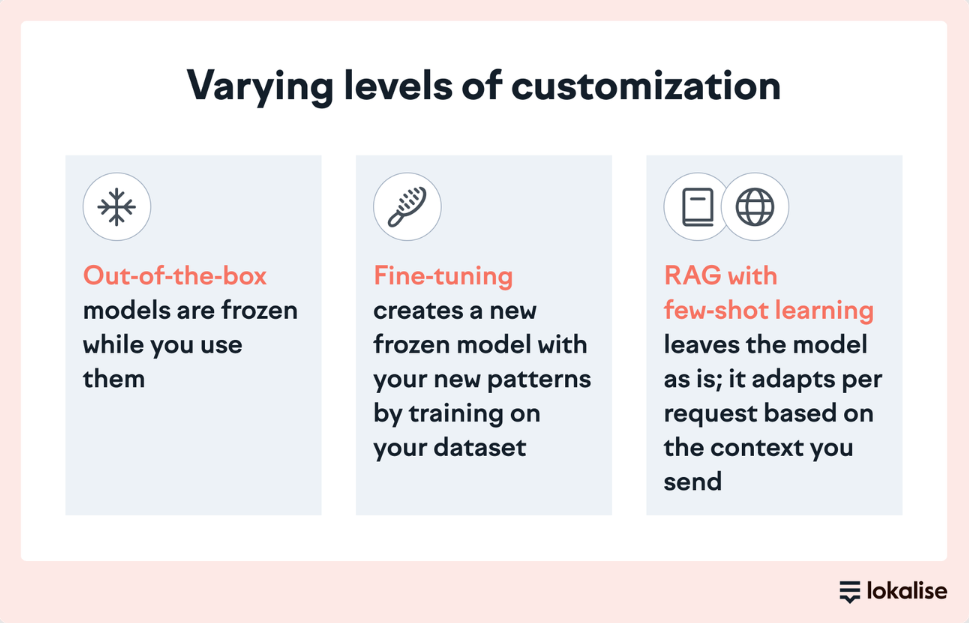
Retrieval (RAG) verbindet Modelle mit deinen genehmigten Übersetzungen

Workflows mit Retrieval-Augmented Generation (RAG) verbessern die Übersetzungsgenauigkeit, indem sie die Ergebnisse des LLM auf freigegebene Beispiele aus dem Translation Memory und früheren Versionen stützen.

Das ist wichtig, weil Kontext den Unterschied zwischen „gut“ und „produktionsreif“ ausmacht. 

Statt zu raten, wie die bevorzugte Formulierung lautet, ruft das System relevante frühere Übersetzungen ab und nutzt sie als Referenz. Das erhöht textübergreifend die Konsistenz, reduziert halluzinierte Terminologie und macht Übersetzungsergebnisse in großem Maßstab besser vorhersehbar.

Ebenen der Anpassung in der LLM-Übersetzung.webp

AIQE-Bewertungen ermöglichen ein automatisches Routing nach Qualität

Automatisierung funktioniert nur, wenn Qualität messbar ist. Die AIQE-Bewertung schätzt die Übersetzungsqualität auf Segmentebene ein und ermöglicht automatisierte Routing-Entscheidungen.

Wenn eine Übersetzung einen definierten Qualitätswert erreicht, kann sie automatisch freigegeben werden. Wenn sie unter diesen Schwellenwert fällt, kann sie zur Überprüfung markiert werden.
So können Teams menschliches Know-how für risikoreiche oder mehrdeutige Inhalte reservieren, anstatt standardmäßig jede Übersetzung zu prüfen.

Automatische Bewertung LLM-Übersetzung.webp

Warum Orchestrierung wichtiger ist als das Modell

2026 gibt es kein LLM, das für alle Übersetzungen am besten geeignet ist. Es gibt aber jeweils das beste Modell für die aktuelle Aufgabe.

Claude ist in der Regel die sicherste Wahl, wenn Tonfall und Nuancen wichtig sind, GPT-4o/5 ist eine starke Option, wenn du strikte Genauigkeit bei Variablen und strukturierten Formaten brauchst, Gemini ist hilfreich, wenn du lange Dokumente übersetzt oder bei vielen Dateien Einheitlichkeit erreichen musst, und DeepSeek kann sinnvoll sein, wenn du einen hohen Output zu geringeren Kosten benötigst.

Die Auswahl des richtigen Modells sollte weder die Entscheidung einer einzelnen Person sein noch einmalig stattfinden. Die zuverlässigsten Workflows leiten jede Aufgabe an das richtige Modell weiter, geben dem Modell mit deiner abgesegneten Terminologie und früheren Übersetzungen die richtige Grundlage und entscheiden anhand von Qualitätssignalen, was veröffentlichungsreif ist und was noch überprüft werden muss.

Diese Herangehensweise ändert sich nicht, selbst wenn sich Modelle ändern. Auf diese Weise lässt sich die Übersetzungsqualität am einfachsten beibehalten, ohne deine Pipeline zu verlangsamen.

Möchtest du mehr erfahren? Sieh dir dieses Webinar an und erfahre, wie auch du mit KI 90 % veröffentlichungsreife Übersetzungen erzielen kannst.

🧠 So funktioniert die AIQE-Bewertung in Lokalise

In Lokalise erhält jedes übersetzte Segment einen AIQE-Score zwischen 0 und 100, basierend auf dem MQM-Standard (Multidimensional Quality Metrics), sodass Teams die Qualität einschätzen können, ohne alles manuell prüfen zu müssen.

Der Score soll das Routing unterstützen. Ein hoher AIQE-Score (typischerweise ≥80) zeigt an, dass die Übersetzung in der Regel sicher automatisch freigegeben werden kann oder nur ein kurzes Überfliegen erfordert, während ein niedrigerer Score (<80) darauf hinweist, dass eine menschliche Überprüfung dringend empfohlen wird.

In der Praxis ist es dieser Score, der KI-Übersetzungen vertrauenswürdig macht.

Autor

rachel wolff headshot

Lead copywriter

Das ist Rachel, unsere Content Managerin und leitende Copywriterin, die von der Werbung ins SaaS-Geschäft wechselte und es nie bereut hat. 

Rachel ist in Großbritannien geboren und aufgewachsen und hat in London, Paris, Buenos Aires und jetzt in Brüssel gelebt. Durch ihre Stadtwechsel, ihre Reisen und ihr Studium in Französisch und Journalismus hat sie Französisch und Spanisch gelernt – und erfindet inzwischen mit Hilfe ihrer dreijährigen Tochter ihre eigene Sprache: Franglospanisch! 

Außerhalb der Arbeit macht (und isst) Rachel gern frische Pasta, zeichnet und verbringt so viel Zeit wie möglich draußen – beim Radfahren, Wandern oder Laufen.

Zugehörige Artikel

Best translation tools

Die besten KI-Übersetzungstools im Jahr 2026

Können KI-Übersetzungstools menschliche Übersetzer wirklich ersetzen? Noch nicht ganz, aber sie können dir trotzdem eine Menge Zeit und Aufwand ersparen. Bei Lokalise haben wir die zehn besten KI-Übersetzungstools getestet, um herauszufinden, welche deine Aufmerksamkeit verdienen. Egal, ob du schnelle Dokumentenübersetzungen, Website-Lokalisierung oder mehrsprachige Unterstützung in Echtzeit brauchst – wir haben die passende Lösung für dich.
May 1, 2024·Rachel Wolff
Localization management scaled

Die 5 besten Translation-Management-Systeme, die Projekte einfacher gestalten

Das traditionelle Translation-Management-System (TMS) ist tot. Es unterstützt die vielen dynamischen Bestandteile des mehrsprachigen Content-Lebenszyklus nicht, darunter Verwaltung linguistischer Ressourcen und Synchronisierung mit Designsystemen, Integration in Codebasen, Automatisierung der Qualitätssicherung und Koordination von Interessengruppen über alle Funktionen hinweg. Moderne TMS-Lösungen gehen weit über reine Übersetzungen hinaus. Sie vereinen Übersetzer*innen,

July 1, 2025·Shreelekha Singh
SRT scaled

Was ist eine SRT-Datei? Untertitelformat erklärt

Eine SRT-Datei ist eine reine Textdatei, mit der Untertitel zu Videos hinzugefügt werden. Es ist eines der einfachsten und gebräuchlichsten Formate. Wenn du schon einmal Untertitel bei einem YouTube-Video eingeschaltet hast, ist die Wahrscheinlichkeit groß, dass im Hintergrund eine SRT-Datei verwendet wurde. SRT-Dateien kommen bei den unterschiedlichsten Anwendungen zum Einsatz, z. B. Social-Media-Clips, Online-Kurse, Interviews oder Filme. Sie sind leicht zu erstellen,

June 19, 2025·Ilya Krukowski

Verschwende keine Zeit mehr mit manuellen Lokalisierungsaufgaben.

Bring globale Produkte schon in wenigen Tagen auf den Markt.

  • Lokalise_Arduino_logo_28732514bb (1).svg
  • mastercard_logo2.svg
  • 1273-Starbucks_logo.svg
  • 1277_Withings_logo_826d84320d (1).svg
  • Revolut_logo2.svg
  • hyuindai_logo2.svg